心理所研究發現漢語閱讀中詞切分的競爭機制
漢語文本中,詞匯與詞匯之間沒有空格,詞匯的切分問題,即讀者如何將連續的漢字切分成不同的詞匯,是理解漢語文本加工機制的重要研究內容。漢語文本切分的難點之一在于存在大量的重疊歧義詞(指的是句子中一串字中間的一個漢字可以分別和左右兩側的漢字組成詞匯,例如在字符串“花生長”中,中間的漢字“生”既可以和左側漢字組成“花生”,也可以和右側漢字組成“生長”)。心理所行為科學重點實驗室李興珊研究組創造性地以重疊歧義詞為切入點,通過三個實驗區分了漢語閱讀中詞切分的三種可能假設:左側優勢假設、獨立加工假設以及競爭假設。
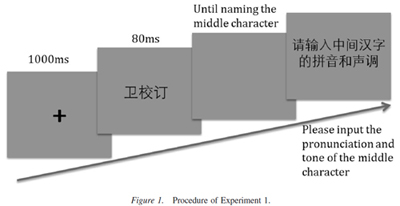
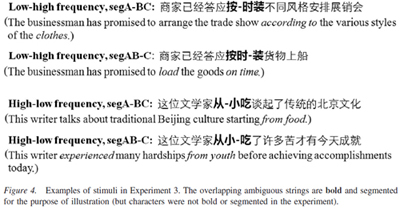
實驗一主要探討漢語詞匯切分是否遵循絕對“左側優勢假設”,即是否只有左側詞匯能夠競爭獲勝。該實驗采用中間漢字是多音字的重疊歧義詞,并操縱左右兩邊的詞匯頻率,一個是高頻詞,另一個是低頻詞,要求大學生被試報告中間漢字的發音。結果發現讀者傾向于報告該漢字在高頻詞下的發音,不管這個高頻詞在左邊還是在右邊。因此,實驗一否定了絕對的左側優勢假設,表明右側詞匯也能在競爭中獲勝。實驗二在正常句子閱讀條件下,探討中文詞匯切分是否遵循“獨立加工假設”,即左右兩側的詞匯是否獨立加工、互不影響。實驗結果發現,左側詞匯的注視時間受重疊歧義詞右側的詞匯頻率的影響,表明左右兩側詞匯的加工并不是相互獨立的。實驗三在正常句子閱讀條件下,同時檢驗三種假設,發現重疊歧義詞左右兩側詞匯存在競爭關系,高頻詞更容易競爭獲勝,不管該高頻詞匯在左側還是在右側。上述實驗支持“競爭假設”,說明了在重疊歧義詞加工過程中,存在詞匯競爭的切分機制,不管該詞在左邊還是右邊,如果激活足夠強,將會在競爭中優先勝出。
該研究受國家自然科學基金項目(31070904)、中科院知識創新工程項目(KSCX2-YW-BR-6)以及美國國立衛生研究院(HD065829)的支持。研究成果已在線發表于Journal of Experimental Psychology: Human Perception and Performance期刊。該文章獲得期刊四位審稿人的一致好評,主編Kathleen Rastle教授總結后的評價是“研究出色,實驗簡潔,寫作很好,探討了中文詞匯識別中的關鍵問題(this is excellent work - a very well-written manuscript reporting a series of elegant experiments that address key issues around Chinese word recognition)”。
論文信息:Ma, G., Li, X., & Rayner, K. (2014, January 13).Word segmentation of overlapping ambiguous strings during Chinese reading. Journal of Experimental Psychology: Human Perception and Performance. doi: 10.1037/a0035389
附件下載: